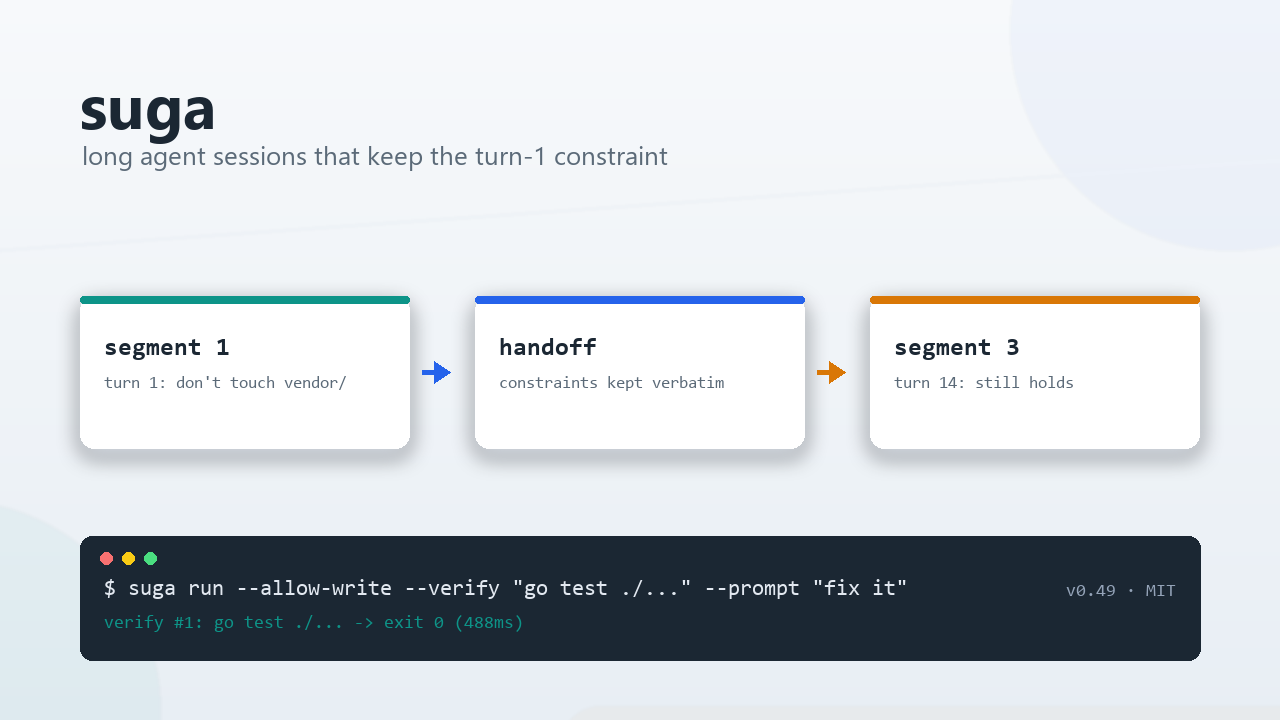
让 agent 跑 14 轮、换 3 次段还记得第 1 轮的约束:suga 的长会话做法
agent 在一个会话里干久了,会出三种问题:上下文塞满后开始压缩,压缩掉的恰好是你第一轮交代的约束;每次请求都背着几千 token 的固定开销,会话越长越贵;出了问题想回头查“它到底做了什么”,却没有记录可查。
suga 是我用 Go 写的个人 coding agent,目标是一个会话能陪我干一整天活。这篇讲它在长会话上的几处取舍,哪些有数据支撑、哪些试过没成,以及它和我的任务平台 gofer 怎么配合。suga 本身就是在 gofer 上由 agent 一批批写出来的。
当前版本 v0.49,
v0阶段次版本之间可能有不兼容变更;MIT 许可;以下是suga的一些介绍。
- 仓库:github.com/inhere/suga
- 发布页:releases/latest(Linux / macOS / Windows 二进制)
一个会话用一整天,难点在“换段”
上下文窗口迟早会满。常见做法是满了就把旧消息压成一段摘要继续跑。问题在于摘要是模型写的,它会“合理地”丢掉它认为不重要的东西——比如你在第 1 轮说的“不要动 vendor/”。
suga 的做法是分段:上下文快满时开新的一段,旧段落盘、可检索,新段开头带一份交接包。交接包是固定结构的:当前任务、坐标(文件/符号/行号)、采纳与否决、验证到哪、进展与阻塞、下一步、可回查的引用。其中“采纳与否决”这一节放硬约束、规则和用户原话,规定逐字保留、不设长度上限、不得改写;其余各节有字节预算(例如坐标 ≤2 KB),旧坐标在折叠时按文件+符号去重。
为什么要预算:早先的交接包每换一次段就把上一份整篇折进来,实测一个 14 轮的会话里交接包从 4.7 KB 涨到 7.8 KB 再到 16 KB,后面每次请求都背着它。加预算后,同样的任务换段后上下文稳定在 7.2k–8.7k token。
验证这件事的是一组“难版长会话”评测:每个任务 13–14 轮、强制换段 2–3 次,中间塞大文件和无关工作,最后一轮专门检查第 1 轮的约束还在不在,例如:
- 约束中途被用户改过,检查守的是新约束而不是旧的;
- 话题 A → B → C → 回 A,检查不串题;
- 工具输出里藏着“忽略之前的规则”,检查没被带偏。
真实模型(deepseek-v4.1-flash)每个任务跑 3 次,当前 12/12 通过。
这里栽过一次跟头:给“写交接包”这次模型调用加了一个按预算算出来的输出上限(约 3.3k token),单测和假模型评测全过。换真实模型一跑,4 个任务里 3 个在换段时报“摘要为空”——推理模型的思考过程也占输出额度,额度用完时正文还没开始写。现在这个调用不设上限,包的大小由预算和事后按节截断来保证。教训是:涉及模型行为的改动,假模型测不出来,必须过真实模型。
每个 token 都有账:固定前缀、工具描述、按需加载
先看一句最短的提问(v0.48 实测):
suga run --prompt "只回答 ok 两个字"ok
opencode-go/deepseek-v4.1-flash · in 8853 / out 2 tokens · 2.8s10 个字的提问,请求输入 8,853 token。钱花在哪,suga inspect trace <session> --json 的 context 事件逐项给出:
| 部分 | 字节 | 说明 |
|---|---|---|
tools | 19,753 | 只读会话的 16 个工具 schema,比下面三项加起来还大 |
rules | 6,782 | 工作区 AGENTS.md 与本地上下文文件 |
system | 3,559 | 稳定的系统提示词 |
skills | 1,333 | skills 列表 |
provider 的缓存按前缀匹配,所以前缀要稳定:工具表、系统提示词、段上下文在会话里不乱变,后面的请求才能复用前面的缓存。如果每次请求都往系统提示词里塞时间戳或随机 ID,缓存就会失效,账单会涨。后面讲的 thinking 签名问题,也是同一个原因。
长会话的成本形状是“调用次数 × 每次的上下文”。对一个 14 轮任务的逐次调用拆账,发现 29% 的输入是每次都要重发的固定前缀:系统提示约 0.9k token,20 个内置工具的 schema 约 7.0k token。
于是做了两件事:
- 精简工具描述:删掉解析器细节、各工具重复写的约定(比如 5 个搜索工具各写一遍“默认跳过 vendor/node_modules”),统一挪到系统提示里说一次。每次调用省约 920 token,并加了一个测试把每个工具 schema 的字符数钉住,防止以后再涨回去。
- 低频工具按需加载:20 个工具里有 11 个在 128 次评测运行中合计只被调用 44 次。设想是把它们从工具表里拿掉,只留一行清单,用到时再加载。
两件事都出过岔子,都是评测发现的:
- 精简后,一个任务的调用数反而涨了 24%。翻会话记录发现,
no_ignore参数说明里“会跳过 vendor/”这几个字被删了,模型看不到,就改用 shell 去列 vendor/ 目录。把这几个字补回来,调用数回到原来的水平。 - 按需加载先做了一次探针:把工具 schema 只写在消息文本里、不放进
tools声明,三个模型 9 次里 0 次发起原生调用,模型不会调用没声明的工具。所以段内要靠一个常驻的代理工具tool_call来调,到换段时再正式入表,这样段内工具表不变、缓存不失效。可开关对比的结果是:每次调用的 prompt 少了 16.9%,但调用数多了 8.3%,总量只省 6.8%,没过“调用数上升不超过 5%”的门槛。所以这个功能默认关着,tools.deferred_native: auto才开启。
后来这类对比做成了评测里的 compare 子命令:两组结果按任务对齐,给出 helped / hurt / no observed effect / confounded 的结论并写进台账,免得每次手算。
出了问题能查:从一次 thinking 签名错误说起
suga 把每次运行写进同一个 SQLite:会话、回合、每次模型调用的 token 与缓存命中、每次工具调用、换段、审批、收工检查。agent 出问题的方式很固定:绕圈、重复跑同一条命令、写完不验证、自称“已完成”,有了时间线这些都看得出来。下面是一次修 bug 运行的摘要(v0.48 实测):
suga inspect trace <session> --analyzesteps 5 model calls, 6 tool calls, 2 parallel steps (max 2 calls in one step)
tokens in 51.2k (cache read 40.4k), out 427; reasoning 77 chars, text 478 chars
tools file_read x2, shell_exec x2, file_edit x1, file_list x1
re-reads -
reads after own write 0
shell 2 runs, 1 failed (exit != 0), 0 exited 0 with stderr output
repeated commands command=go test ./... x2
tests 2 runs, 0 after the first pass
phases explore 2, first write to green 2, after green 1 (model calls)re-reads、reads after own write、repeated commands、tests 这几行就是为“绕圈”和“没验证”设计的。--transcript 把同一个会话渲染成纯文本,适合贴进 review 或交给另一个 agent;--web 打开一个只读页面,适合挂着看长跑。trace 是事后记录,拦不住 agent 绕圈,也替代不了测试。
再举一个靠它查出来的问题。某天用 Claude 跑多步工具调用,第二轮请求被拒:Invalid signature in thinking block。对比两轮请求后找到两个原因:
- 模型省略的可选参数被规整掉以后,
tool_use.input回传成了null; - Anthropic 现在把 thinking 块的签名绑定到它生成时的请求前缀,而 suga 每一步都在请求里附一条“距截止还剩约 N 分钟”的提醒——文字每步都变,前一步的 thinking 就验不过了。
修法是回传 {},并让这条提醒在一个回合内文字和位置都固定。之后把 deepseek、glm、Claude、codex 四家的真实流式响应录成回放夹具(去掉密钥),这类协议细节再变,单测会先发现。
默认安全,“测试通过”要由外部命令来说
默认只读;开了写权限后,写文件和跑命令前在 chat 里问你(y / n / a 本会话不再问),规则可以按工具、路径、命令写成文件。文件工具写之前都会留快照,:undo / suga undo <会话> 能回退;shell_exec 造成的改动只登记、不回滚,这是有意的。
模型说“已修复、测试通过”不算数。--verify 在回合结束后由 suga 自己跑你给的检查命令,失败就把输出作为新回合还给模型修(默认最多 2 轮)。一个只有一处 bug 的小仓库:
suga run --allow-write --verify "go test ./..." --prompt "calc.go 里的 Add 有 bug,先跑测试确认,再修好它"已确认并修复。
**确认 bug**:修复前 go test ./... 失败 —— calc_test.go:7: Add(2,3) = -1, want 5。
**原因**:calc.go:5 里 Add 写成了 a - b。
**修复**:改为 return a + b。
verify #1: go test ./... → exit 0 (488ms)最后那行 verify #1 才是证据。同一回合里还有收工检查(nudge):写了文件却没跑过任何检查命令、计划里还有没做完的步骤、答案以“接下来我去跑测试”结尾,都会被推回去一次。
还有一处:审批是人做的,模型并不知道。有一次 suga 作为常驻会话替我回信,信里说“写文件没有触发审批”,实际上是我批准后才写的。现在经人工批准的调用,模型看到的结果末尾会多一行 [已经人工批准执行],它就不用猜了。
和 gofer 配合:suga 是怎么被写出来的
gofer 是我的另一个项目,把 codex、claude、suga 这类 agent 接成异步任务:提交 job、在独立 git worktree 里干活、web/钉钉上审批、看日志和 token 用量、合并回主分支。suga 在 gofer 里有两种用法:
suga run:一次性任务,跑完退出,stream-json 输出事件;suga acp:常驻会话,每次工具调用的审批通过 ACP 交给 gofer,在 web 或钉钉上点。
suga 自己的开发就是这么跑的:
监督会话(读计划、写任务说明、审核、发版)
   │  gofer job run -a suga --model <deepseek | glm | codex> --worktree ...
   ▼
多个 suga 实施 job 并行,各在自己的 worktree + 分支里改代码、跑测试、提交
   │  完成后监督审核 diff、在 Linux 容器补跑 race 与伪终端冒烟
   ▼
gofer job worktree merge → suga-verify 工作流
   (Linux race / CI 模拟 / staticcheck / Windows 测试 + ConPTY 冒烟 / 40+ 个伪终端场景)
   ▼
打 tag → GitHub Actions 出三平台二进制 → 上传
不同模型交叉派活、记录每次审核的结论;需要设计的改动先出设计、评审、经人批准,再出计划、经批准才实施。到 v0.49 一共 56 个 tag、2400 多个提交;最近几十批改动,代码基本都是 suga 实施 job 写的,我负责拆任务、审核和发版。
这个流程里最有价值的反而是“审核”:实施方经常在自己验证不了的地方出错,比如在 Windows 上写的伪终端冒烟没真正跑过、假模型的分支链被一句赋值截断、测试等到了输入行的回显就以为回合结束了。这些都是在合并前的容器复跑里抓到的。
两边还有几处直接的配合:gofer 给常驻的 suga 会话发信(agent:suga),suga 用 gofer 的信箱工具回信;suga 的会话之间能互相发消息(suga send),带消息 ID、合并投递、处理回执和失败屏障;gofer 的记忆后端可以给 suga 当长期记忆用。
内核能嵌进别的 Go 程序
pkg/agentcore 是应用层之下的内核:模型/工具循环、可恢复的运行状态、provider、工具注册与审批、MCP、skills、长期记忆。它不依赖 internal/*,这条边界由 pkg/agentcore/layering_test.go 里一张白名单表守着,表外依赖和未登记的新包都会让测试失败。最小可运行的组合只要一个 provider:
runtime := agentcore.New(agentcore.Config{
    Provider: mock.NewProvider(mock.Final("hello")),
})

result, err := runtime.Run(ctx, agentcore.RunInput{
    AgentID:     "example-agent",
    Instruction: "say hello",
})
// result.Output == "hello"
接真实模型换成 llm.NewOpenAIProvider(...),加工具用 reg.Register(...),控权限在外面包一层 tools.NewApproval:没配审批方时一律拒绝,而不是放行。限制也写在这里:只做单 agent 循环,不做多 agent 编排;pkg/sugasdk(进程内 Open / Send / Event)标着 experimental。
和同类工具对比
Claude Code、Codex CLI 是模型厂商自己做的,模型适配和交互打磨得更好;aider 的 git 工作流很成熟;opencode 的 TUI 体验好。suga 的取舍不同:
- 单个 Go 二进制,没有运行时依赖;Windows 是一等平台(PowerShell、Job Object 进程树、ConPTY 冒烟);
- 会话持久化、分段与交接、长会话评测与回归门,是它花力气最多的地方;
- 能嵌进别的 Go 程序(
pkg/sugasdk),也能作为 ACP 服务被编辑器或 gofer 驱动; - 多家 provider 可切换,配置里能写备选模型,连接失败时直接切下一个。
不适合的情况:
- 想要 IDE 插件或图形界面:目前只有终端;
- 想要多 agent 编排:子 agent 只做一次只读调研,不会递归派活;作业队列、控制台这些在 gofer 那一侧;
- 不想自己配 provider 密钥:所有请求直连你配置的地址,没有托管服务;
- 需要英文文档:详细文档是中文的内置 skill
suga-guide; - 需要稳定接口:
v0阶段。
我主要在 Windows 和 Linux 上用,CI 跑 Ubuntu 与 Windows;macOS 有构建产物,但我很少用。
30 秒上手
eget install inhere/suga          # 或 go install github.com/inhere/suga/cmd/suga@latest
suga init                         # 生成 ~/.suga/config.yaml 与 .env
# 在 ~/.suga/.env 里写一个密钥,例如 DEEPSEEK_API_KEY=...(内置 openai / anthropic / deepseek)
suga config set model deepseek/deepseek-chat
suga chat # 在当前目录开始;:help 看命令,:context 看上下文构成一次性任务:suga run --prompt "总结一下这个项目";要它改代码并自查:suga run --allow-write --verify "go test ./..." --prompt "修好失败的测试"。
如果读代码,从这四处进
internal/cli:一个命令一个文件,root.go里能看到整棵命令树;internal/wiring:把 provider、工具、skills、系统提示词、runner 组装起来,CLI 和 ACP 共用;internal/personal:回合、分段、交接包和事件,读它就是读 suga 的产品逻辑;pkg/agentcore:内核与能力层,先看layering_test.go那张表。
docs/ 下有 45 篇设计、32 篇计划、13 篇调研,“为什么这么做”基本都在里面,文中的数字大多出自 docs/research。
我是 inhere(博客 · GitHub),suga 的作者。文中数字来自 v0.48–v0.49 的实测运行和仓库
docs/research下的报告,命令都在正文里,可以自己复现。